GGUF, bir yapay zekâ modelinin ağırlıklarını ve çalıştırma için gerekli bilgileri saklayabilen bir dosya biçimidir. Kuantizasyon, ağırlıkların sayısal hassasiyetini azaltarak daha küçük bir temsil kullanma yöntemidir. Yerel model indirirken GGUF uzantısı dosya biçimini, Q4 veya Q8 gibi etiketler ise kullanılan temsil türü hakkında bilgi verir.[1][2][3]
Bu rehber, aynı modelin farklı dosyaları arasında nasıl seçim yapacağınızı açıklıyor. Dosya adı, disk alanı, çalıştırma belleği ve çıktı kalitesini ayrı kontrol edeceğiz. Örnek bellek hesabı yalnızca ağırlık boyutunu anlamak için hazırlanmıştır.
GGUF dosyasının içinde ne bulunur?
GGUF teknik tanımında modelin tensörleri ve bunlara ilişkin bilgileri taşıyan ikili bir dosya biçimi olarak açıklanır. Dosya, yükleyicinin modeli tanımasına yardımcı olan meta veriler de içerebilir. GGML tabanlı çalıştırıcılarda kullanılmak üzere tasarlanmıştır.[1][2]
Bir model deposunda aynı taban modelin farklı boyut ve kuantizasyon seçeneklerini görebilirsiniz. Modelin adı, parametre sayısı, sohbet için uyarlanmış sürümü ve dosyanın kuantizasyon türü ayrı özelliklerdir. Dosya adına bakarak bu bilgilerin hepsini kesinleştirmek yerine depo açıklamasını ve model kartını okuyun.[1][2]
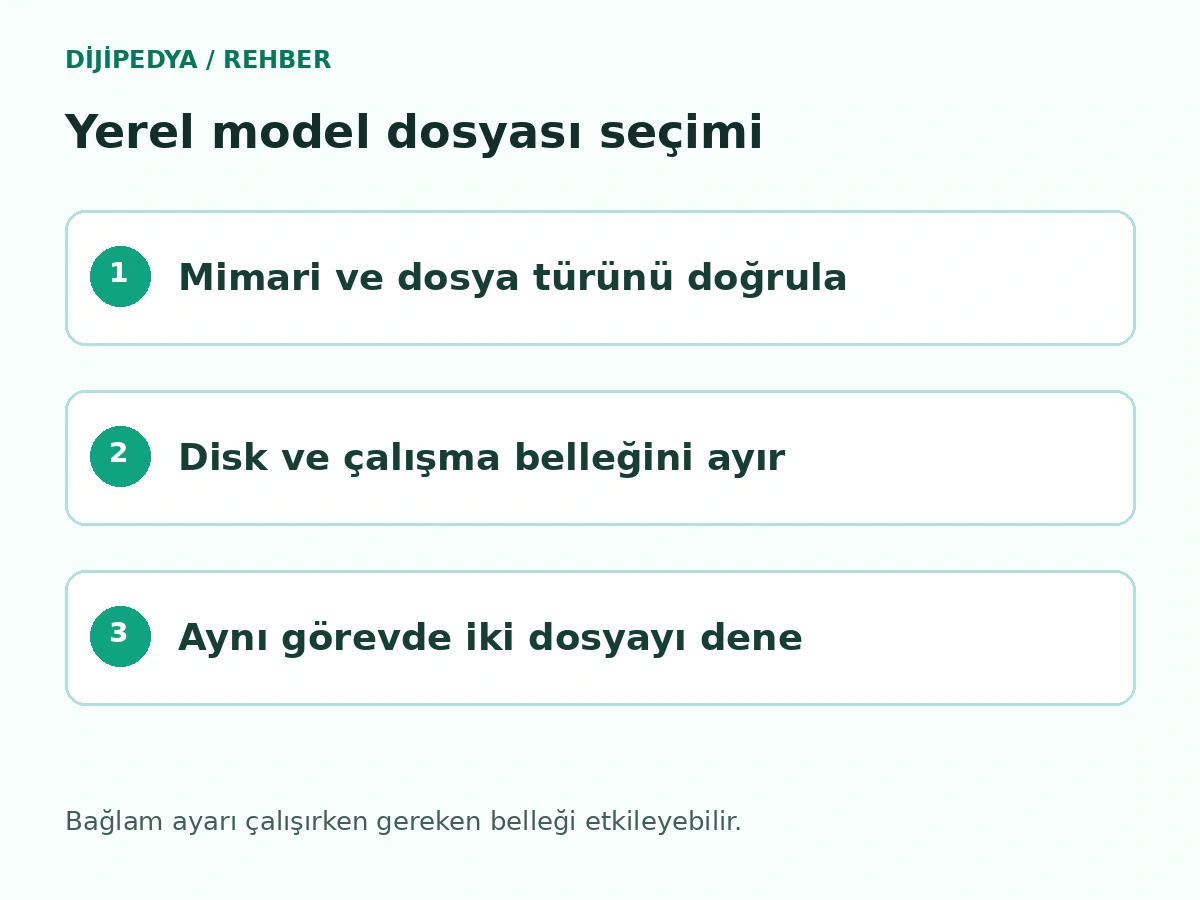
Çalıştırıcınızın model mimarisini ve ilgili dosyayı desteklediğini doğrulayın. Bir yazılımın GGUF dosyası açması, her GGUF model ailesini çalıştıracağı anlamına gelmez. Görsel veya ses alan modellerde ek dosya ya da farklı destek koşulları olabilir.[2][3]
Kuantizasyon neyi değiştirir?
Kuantizasyon ağırlık değerlerini daha düşük hassasiyetli temsillere dönüştürür. Amaç, model dosyasını ve ağırlıkların kapladığı alanı küçültmektir. Kullanılan yöntem ve donanıma bağlı olarak hız etkisi değişebilir. Hassasiyetin düşmesi bazı görevlerde kalite kaybı oluşturabilir.[3]
Farkı anlamak için çok ayrıntılı sayıların daha az basamakla saklandığını düşünün. Gerçek yöntem, basit ondalık yuvarlamadan daha karmaşık olabilir. Ağırlıklar bloklara ayrılabilir ve ölçek bilgisi eklenebilir. Bu yüzden dosya etiketindeki bit sayısı, dosyanın bütün baytlarına doğrudan uygulanabilecek tek bir değer değildir.[2][3]
Modelin parametre sayısı ile kuantizasyon düzeyini ayırın. Bir model ailesinin 7B ve 14B sürümleri, farklı parametre sayıları taşır. Aynı modelin Q4 ve Q8 dosyaları ise ağırlıkların nasıl temsil edildiğine ilişkin farklı seçenekler sunabilir. Sadece dosya boyutu benzer diye iki modelin görev başarısını aynı kabul etmeyin.
Q4, Q5 ve Q8 etiketleri nasıl okunur?
Hugging Face GGUF belgeleri, farklı kuantizasyon türlerini ve blok yapılarını listeliyor. Q4, Q5 ve Q8 gibi aileler bit düzeyi hakkında fikir verir. Aynı ailedeki ek harfler farklı teknik seçimleri gösterebilir. Dosya deposundaki açıklama ve gerçek dosya boyutu karar için daha belirleyicidir.[2]
| Dosya etiketinde görülen | Ne incelenmeli? |
|---|---|
| Q4 ailesi | Daha küçük temsil seçeneği ve görevdeki kalite |
| Q5 ailesi | Boyut ile kalite arasındaki fark |
| Q8 ailesi | Daha büyük dosyanın bellek ve hız etkisi |
| F16 veya BF16 | Daha yüksek hassasiyetli dosyanın kaynak ihtiyacı |
| Ek harfler veya bölünmüş dosya | Depo açıklaması ve çalıştırıcı desteği |
Bu tablo belirli bir modelin performans sıralaması değildir. Kendi bilgisayarınızda iki dosyayı aynı ayarla çalıştırıp karşılaştırın. Daha küçük dosyanın her donanımda daha hızlı olacağını veya daha büyük dosyanın her soruda daha iyi cevap vereceğini varsaymayın.[3]
Dosya boyutu için yaklaşık hesap
Yedi milyar ağırlığın her biri tam olarak dört bit kaplasaydı, çıplak hesap 7 milyar × 4 ÷ 8 olurdu. Sonuç yaklaşık 3,5 milyar bayt, yani ondalık ölçekte 3,5 GB. Aynı kaba varsayımla 16 bit yaklaşık 14 GB eder. Bu hesap, aynı sayıda değeri farklı hassasiyetle saklamanın neden boyutu değiştirdiğini gösterir.
Gerçek dosyada başlıklar, meta veriler, blok ölçekleri ve farklı türde saklanan tensörler bulunabilir. Bazı kuantizasyon türlerinde ağırlık başına ortalama bit sayısı, adındaki nominal sayının üstündedir. Bu nedenle satın alma veya indirme kararını yalnızca formüle göre vermeyin. Model deposundaki gerçek boyutu kontrol edin.[1][2]
GB ile GiB değerlerini karşılaştırırken birimlerin aynı yazıldığından emin olun. İşletim sistemi ve dosya sayfası farklı birim gösterebilir. Aynı büyüklüğü farklı sayı olarak görmek, dosyanın bozuk olduğu anlamına gelmez. Kendi karşılaştırma tablonuzda birimleri açıkça belirtin.
RAM, VRAM ve bağlam penceresi
Diskte görülen model dosyası boyutu, çalışırken gereken toplam belleği tek başına belirlemez. Çalıştırıcı ve modelin bağlam için tuttuğu veriler de bellek kullanır. Ollama’nın belgeleri daha büyük bağlam ayarının daha fazla bellek gerektirdiğini açıklıyor.[5]
RAM sistem belleğidir. VRAM ise ayrı ekran kartı bulunan sistemlerde grafik işlemcinin kullandığı bellek olarak karşınıza çıkabilir. Hangi katmanların hangi bileşende çalıştığı, uygulamanın yükleme ve donanım ayarlarına bağlıdır. Bir modelin açılması, uzun belge veya büyük bağlamla rahat çalışacağını göstermez.[5]
Önce küçük bir görevle deneme yapın. Model yükleniyor mu, bilgisayar kullanılabilir durumda kalıyor mu ve kısa yanıt ne kadar sürede geliyor? Ardından gerçek işinizdeki uzunluğu temsil eden bir metni deneyin. Bağlam penceresi rehberi modelin işlem sırasında hangi metni gördüğünü açıklıyor.
Bir dosyayı indirmeden önce neyi kontrol etmeli?
Önce güvenilir bir model deposu ve açık model kartı seçin. Taban model, yayınlayan kişi veya kuruluş, lisans ve dosya sürümü belli olsun. Aynı adla yayımlanan farklı dönüşümler olabilir. Model kartı belirsizse dosya adındaki tanınmış markayı güvenilirliğin yerine koymayın.
Ardından kullandığınız yerel uygulamanın desteklediği biçimi inceleyin. Örneğin Ollama, uyumlu GGUF dosyalarını bir Modelfile ile içe aktarmayı belgeliyor. Başka bir aracın model içe aktarma biçimi farklı olabilir. Ollama ve LM Studio rehberimiz yerel kurulum seçeneklerini karşılaştırıyor.[4]
Dosya birkaç parçadan oluşuyorsa gerekli parçaların tamamını kontrol edin. İlk parçayı indirmiş olmak modelin tam olduğu anlamına gelmez. Depoda bir görsel bağlayıcı dosya ayrı verilmişse, metinle sohbet ve görsel girdi özelliklerinin gereksinimleri farklı olabilir.[3][4]
Ollama ile örnek içe aktarma
Ollama’nın resmî kılavuzunda GGUF içe aktarmak için Modelfile içinde dosyanın konumu belirtiliyor. Örnekte dosyanın adı kurgusaldır. İndirdiğiniz dosyanın gerçek yolunu kullanın ve kullandığınız sürümün model mimarisini desteklediğini doğrulayın.[4]
Aşağıdaki satırı Modelfile içine yazın.
FROM ./model.Q4_K_M.gguf
Modelfile ile model dosyasının bulunduğu dizinde aşağıdaki komutları çalıştırabilirsiniz. Örnek, var olan modelin adını değiştirmek yerine deneme için ayrı bir yerel ad kullanır.[4]
ollama create deneme-modeli
ollama run deneme-modeli
Ollama’nın içe aktarma belgesi, GGUF dosyasının içe aktarılırken otomatik kuantize edilmediğini belirtiyor. Dosyanın kuantizasyonunu değiştirmek ayrı hazırlık gerektirir. İlk denemede güvenilir kaynaktan hazır ve uyumlu bir dosya seçmek daha kolay olabilir.[3][4]
Kalite ve hızı nasıl karşılaştırmalı?
Aynı taban modelin iki kuantizasyonunu karşılaştırırken benzer görevleri, aynı bağlam ayarını ve aynı çalıştırıcı sürümünü kullanın. Örneğin kısa Türkçe metni özetleme, sayıları koruyarak tablo yazma ve belirli bir metindeki kaynak bilgisini bulma gibi üç görev seçin. Sonuçları bir göreve bakarak genellemeyin.
Hız için ilk yanıtın gelme süresi ve devamındaki üretim hızını ayrı kaydedin. Bellek için model yüklendikten sonraki kullanım ile uzun girdi sırasında görülen kullanımı karşılaştırın. Sadece boşta çalışır durumda bekleyen modelin ölçümü, gerçek görevi yansıtmayabilir.
Kalite kontrolünde önemli hataları önceden tanımlayın. Bir modelin daha uzun yanıt vermesi, sayıları ve belge koşullarını daha doğru koruduğu anlamına gelmez. İki dosya aynı işi kabul edilebilir biçimde yapıyorsa bellek ve hız farkları daha anlamlı hale gelir.
Model açılmıyorsa hangi sırayla bakmalı?
Önce dosyanın tamamlandığını ve çalıştırıcının mimariyi tanıdığını kontrol edin. Bölünmüş dosyalarda eksik parça olup olmadığını inceleyin. Hata model yüklenirken çıkıyorsa kaynak dosya, uygulama sürümü ve boş bellek ilk bakılacak yerlerdir.[3][4]
Model açılıyor ama uzun soruda yavaşlıyor veya hata veriyorsa kısa bir bağlamla tekrar deneyin. Kullanılan bağlam ayarı, modelin yerleştirildiği bellek ve açık diğer uygulamalar sonucu etkileyebilir. Ayarları birer birer değiştirin. Hem dosyayı hem bağlamı aynı anda değiştirirseniz hangi etkenin sorunu çözdüğünü bilemezsiniz.[5]
Ollama kullanıcıları, belgelenen ollama ps çıktısında yüklenen model ve işlemci dağılımı bilgilerine bakabilir. Görülen değerleri kendi uygulama sürümünüzle karşılaştırın. Sorun tekrarlanıyorsa dosya adı, hata mesajı ve kullanılan ayarları birlikte kaydedin.[5]
Aynı bilgisayarda iki dosyayı deneme planı
Kurgusal bir karşılaştırmada aynı taban modelin iki GGUF dosyasını seçin. Birincisi daha küçük, ikincisi daha yüksek hassasiyetli olsun. İlk işiniz, model deposundan iki dosyanın aynı model ve aynı sohbet uyarlamasından üretildiğini doğrulamak. Aksi halde fark yalnızca kuantizasyondan kaynaklanmayabilir.
İlk denemede kısa bir Türkçe paragraftan üç tarih çıkarmasını isteyin. Çıktıda hangi tarihin hangi olayla eşleştiğini kontrol edin. İkinci denemede daha uzun metin verip bir koşulu ve istisnasını özetletin. İki işte de aynı talimatı ve aynı giriş metnini kullanın. Bu örnekler donanım performansı vaadi değil, karşılaştırma düzenidir.
Her deneme için model dosyasının adı, bağlam ayarı, çalıştırıcının sürümü ve kullanılan donanım kaydedilsin. Bellek göstergesi yalnızca bir bileşeni ölçüyorsa hangi bileşenin izlendiğini de belirtin. Bir dosya başka bir arka plan uygulaması açıkken, diğeri kapalıyken denenmişse sonuçları aynı koşulda ölçülmüş gibi yorumlamayın.
İlk açılışla sonraki çalıştırmalar arasında fark varsa bunu da not edin. Modelin yüklenmesi ile yanıt üretmesi ayrı sürelerdir. Kısa bir soruda yükleme süresi daha belirgin olabilir. Uzun bir görevde ise üretim hızını, bağlam kapasitesini ve yanıtın doğruluğunu birlikte değerlendirin.
Son olarak günlük işinizde kabul edilemez olan hatayı seçin. Örneğin bir içerik editörü için tarihleri karıştırmak, küçük üslup farklarından daha önemlidir. Daha küçük dosya bu hatayı düzenli yapıyorsa, tek kazancınız disk alanı olabilir. İki dosya da görevi başarıyla tamamlıyorsa kendi bilgisayarınızda daha rahat çalışan seçeneği kullanabilirsiniz. Deneme tablosu, hangi dosyayı neden seçtiğinizi bir sonraki güncellemede hatırlamanıza yardımcı olur.
Sık sorulan sorular
GGUF her zaman kuantize edilmiş model mi?
GGUF dosya biçimidir ve farklı hassasiyetlerde ağırlıklar taşıyabilir. Dosyanın türünü belirlemek için model kartındaki veya dosya adındaki açıklamaya bakın.[1][2]
Q4 her bilgisayar için doğru tercih mi?
İhtiyacınız model boyutu, donanım, görev ve bağlam ayarına bağlıdır. Dosyanın kapladığı alanı ve kendi işinizdeki sonucu ayrı ölçün.[3][5]
Daha küçük dosya daha düşük toplam bellek mi demek?
Ağırlıkların kapladığı alan azalabilir. Toplam bellek ihtiyacı çalıştırıcı, bağlam ve diğer bileşenleri de içerir. Kısa ve uzun görevleri ayrı deneyin.[3][5]
Kaynaklar
- GGML, GGUF dosya biçimi teknik tanımı. Bilginin alındığı tarih: 6 Kasım 2026.
- Hugging Face Hub, GGUF. Bilginin alındığı tarih: 6 Kasım 2026.
- llama.cpp, Quantize aracı belgeleri. Bilginin alındığı tarih: 6 Kasım 2026.
- Ollama, Importing a model. Bilginin alındığı tarih: 6 Kasım 2026.
- Ollama, Context length. Bilginin alındığı tarih: 6 Kasım 2026.