Embedding, metin veya başka bir içeriğin bir model tarafından sayılardan oluşan bir vektörle temsil edilmesidir. Vektör araması, bir sorgunun temsilini eldeki içeriklerin temsilleriyle karşılaştırır ve kullanılan ölçüye göre yakın sonuçları sıralar. Bu yöntem, birebir aynı kelimeler kullanılmasa bile ilgili belgeyi bulmaya yardımcı olabilir.[1][2]
Örneğin “siparişim ne zaman çıkar?” sorusu, arşivdeki “kargoya teslim süresi” bölümünü bulabilir. Sonuç, kullanılan modele ve veri düzenine bağlıdır. Ürün kodu ve güncel tarih gibi kesin eşleşmeler için aynı aramanın çıktısını ayrıca kontrol edin.
Embedding ile vektör arasındaki fark
Vektör, belirli sırada duran sayıların listesidir. Embedding ise bir modelin girdiyi bu sayısal uzayda temsil etme biçimini anlatır. Bir belge parçasına ait vektörün tek tek sayıları, “konu”, “duygu” veya “ürün adı” gibi insanlar için hazır sütunlar olarak okunmaz.[1][2]
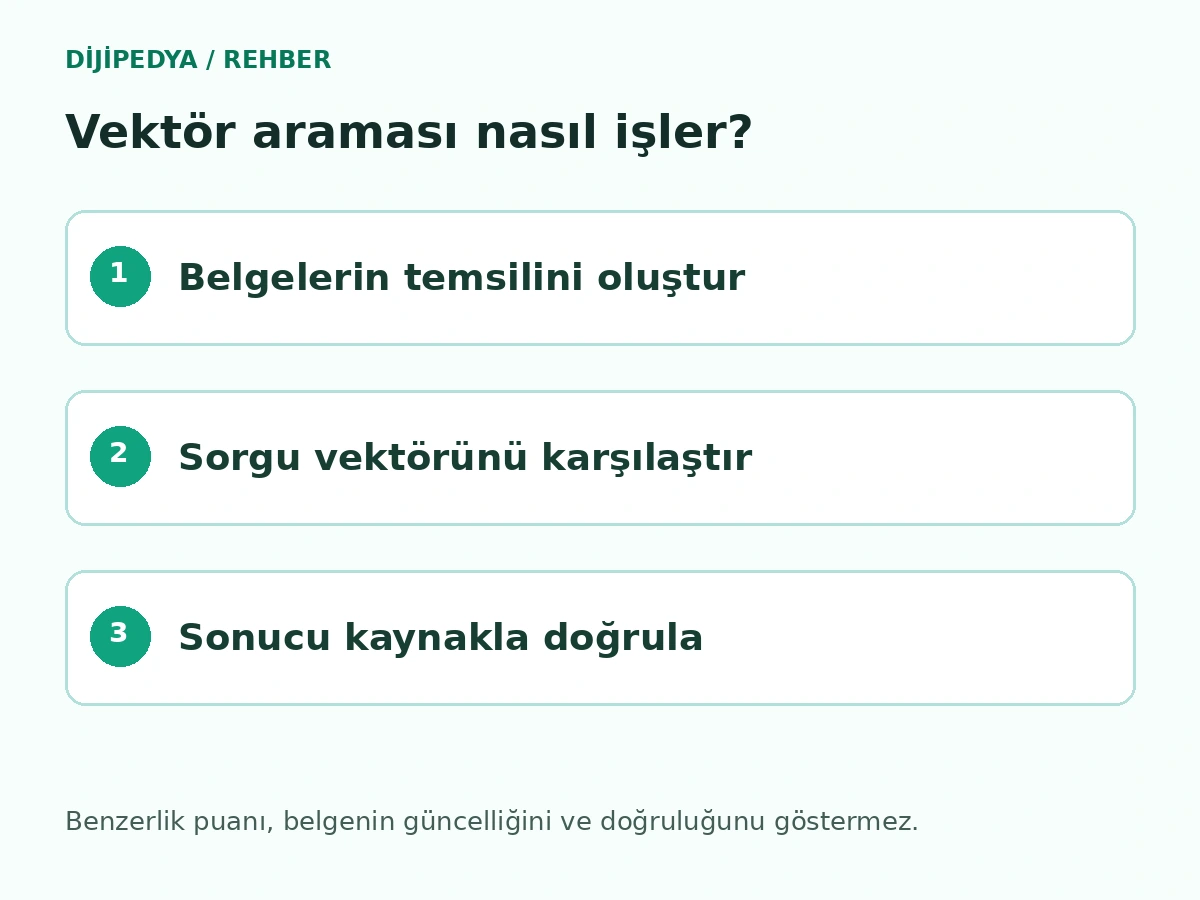
Aynı modelle üretilen iki temsil karşılaştırıldığında modelin öğrendiği benzerlik ilişkilerinden yararlanılır. Benzerlik puanı bir belgenin doğru, güncel veya yetkili olduğunu söylemez. Aranan göreve ne kadar uygun olduğunu değerlendirirken belge tarihi ve erişim izni gibi başka bilgilere ihtiyaç duyabilirsiniz.
Token da sayısal işleme için kullanılan bir kavramdır, ancak işlevi farklıdır. Token rehberinde metnin modele girişte nasıl parçalara ayrıldığını anlatıyoruz. Burada ise belirli metinlerin veya parçaların arama için karşılaştırılabilir temsillerine odaklanıyoruz.[1]
Basit bir yakınlık örneği
Bir sorguya iki sayılık temsili vektör olarak [1, 0] verelim. A belgesinin vektörü [4, 3], B belgesinin vektörü [0, 1] olsun. Kosinüs benzerliği, iki vektörün yönlerinin benzerliğini ölçer. Bu örnekte sorguyla A’nın benzerliği 0,8, B’nin benzerliği 0 olur. Rakamlar gerçek bir embedding modelinin çıktısı değildir. Sıralamanın nasıl oluştuğunu göstermek için seçilmiştir.[1][2]
A’nın ilk sırada çıkması, A’nın kullanıcıya mutlaka doğru cevabı vereceğini kanıtlamaz. Soru A-12 ürününü soruyor ve A belgesi B-30 ürününe aitse, biçimsel benzerlik yüksek olsa da sonuç yanlış ürün hakkında olabilir. Arama sonucunu doğru ürün, sürüm ve içerik koşullarıyla birlikte inceleyin.
Kosinüs, vektörleri karşılaştırmak için tek ölçü değildir. pgvector belgeleri kosinüs uzaklığı, iç çarpım ve Öklid uzaklığı gibi seçenekler gösteriyor. Seçtiğiniz embedding modelinin önerdiği ölçüyü kullanın. Bir uzaklık ölçüsünün küçük değeri ile bir benzerlik ölçüsünün büyük değeri aynı biçimde sıralanmaz.[3]
Aranacak metin nasıl hazırlanır?
İlk olarak belgeyi hangi birimlerde arayacağınızı belirleyin. Bir destek arşivinde soru ve cevabı birlikte tutmak, teknik kılavuzda bölüm başlığını ilgili paragrafla taşımak uygun başlangıçlar olabilir. Bütün belgeleri yalnızca dosya başlığı üzerinden aramak, ayrıntılı soru için gerekli metni kaçırabilir.[1][4]
Kurgusal bir kataloğunuz olduğunu varsayalım. Kayıt başına ürün kodu, belge sürümü, bölüm adı ve paragrafı saklayın. Arama sonucu, vektörün yanı sıra kullanıcıya gösterilecek gerçek metne ve kaynağa ulaşabilsin. Bir vektör tek başına editörün “bu cümle belgede nerede?” sorusunu cevaplamaz.
Özellikle PDF ve tablolarda arama öncesi metin kalitesini kontrol edin. Belgedeki tablo başlığı ve satırlar ayrı sıraya karışırsa embedding, yanlış düzenlenmiş metni temsil eder. OCR rehberi taranmış belgedeki sayı ve sütun ilişkilerini doğrulamak için kullanılabilir.
Sorgu ile belge aynı uzayda nasıl karşılaştırılır?
Sentence Transformers belgeleri, arama görevlerinde sorgu ve belge için uygun kodlama yöntemlerinin kullanılmasını açıklıyor. Bazı modellerde sorgu kısa, belgeler daha uzun ve açıklayıcıdır. Bu nedenle model kartının önerdiği sorgu ve belge giriş biçimine dikkat edin.[1]
Belgeleri bir modelle, sorguları başka bir modelle oluşturup yalnızca boyutları eşit diye sonuçları karşılaştırmayın. Aynı sayıda bileşen, iki temsil uzayının uyumlu olduğunu göstermez. Model veya gerekli giriş biçimi değiştiğinde belge vektörlerinin yeniden oluşturulması gerekebilir. Model adı, sürümü ve boyutunu indeks kayıtlarında tutun.[1]
Türkçe sorguda dil desteğini de değerlendirin. Sadece İngilizce örneklerle iyi çalışan bir modeli Türkçe arşivde doğrudan başarılı varsaymayın. “Yedek parça”, “yedek parçanın” ve marka adları gibi kendi arşivinizdeki gerçek kullanım biçimlerini deneme setine ekleyin.
Kelime araması, vektör araması ve hibrit arama
| Arama türü | Deneme örneği | İncelenecek sonuç |
|---|---|---|
| Kelime araması | A-12 ürün kodu | Tam kod ve doğru ürün |
| Vektör araması | Kargoya ne zaman verilir? | Teslimatla ilgili açıklama |
| Hibrit arama | A-12 kapağını yıkayabilir miyim? | Hem doğru ürün hem ilgili bakım kuralı |
| Filtreli arama | Yalnızca geçerli kılavuzlar | Sürüm ve erişim koşulu |
Vektör araması yakın anlamları bulabilir. Kelime araması tam kodları, özel adları ve belirgin terimleri yakalamada değerlidir. Hibrit arama bu iki kaynaktan gelen sonuçları bir araya getirebilir. Eşleştirme yöntemini kendi soru ve belge örneklerinize göre değerlendirin.[1][4]
Tam kodların doğru çıkmadığı bir testte hemen daha büyük embedding modeli seçmek zorunda değilsiniz. Önce ürün kodunu ayrı filtre veya anahtar kelime olarak uygulamayı deneyin. Aynı sorguya konu benzerliği ile kimlik eşleşmesi gibi iki farklı beklenti yüklediğinizi görünür kılın.
Vektör veritabanı hangi işi üstlenir?
Bir arama sistemi vektörleri, belgeye geri dönüş bilgilerini ve gerekli ek alanları saklar. pgvector, PostgreSQL içinde vektör saklama ve yakınlık sorguları çalıştırma olanağı sunan bir uzantıdır. Başka sistemlerde benzer arama işlemi farklı altyapılarla uygulanabilir.[3]
Aşağıdaki sorgu, üç boyutlu kurgusal bir vektörle örnek bir tabloyu karşılaştırır. Tablo ve vektör değerleri öğretim amacıyla seçildi. Çalıştırmak için pgvector kurulmuş bir veritabanında uyumlu bir tablo ve veri gerekir.[3]
SELECT belge_id, metin
FROM belge_parcalari
WHERE aktif = true
ORDER BY embedding <=> '[1,0,0]'::vector
LIMIT 5;
Buradaki <=> kosinüs uzaklığı operatörüdür. Küçük uzaklık önce gelir. Gerçek uygulamada üç sayıyı elle yazmak yerine sorgu metninden üretilen vektörü uygun yöntemle bağlarsınız. Tabloya erişim sınırlarını uygulamanın kendi yetki düzeniyle kontrol edin.[3]
Kesin arama ile yaklaşık indeks farkı
Küçük bir pilotta kesin aramayla başlamanız, ayarlardan önce doğru sonuç kümesini görmeyi kolaylaştırabilir. pgvector, yaklaşık arama için HNSW ve IVFFlat gibi indeks seçenekleri de sunuyor. Yaklaşık yöntemlerde hız, bellek, indeks kurma ve doğru sonuçları bulma oranı arasında ölçülmesi gereken farklar vardır.[3]
Bir indeks ayarını değiştirirken aynı sorguları kesin arama ile de çalıştırın. Örneğin doğru belgenin ilk beş içinde olup olmadığına bakın. Ardından yanıt süreleri ve bellek gereksinimini kaydedin. Yalnızca ilk sorgunun hızlı dönmesine bakmak, önemli kaynakların kaybolup kaybolmadığını göstermez.
Filtreli sorgularda farklı ürün grupları ve belge sürümleriyle de deneme yapın. Çok az kaydın erişilebilir olduğu bir filtreyle büyük bir arşivde yapılan sorgu, filtresiz örnekten farklı sonuç verebilir. Üretimdeki kullanım biçimini denemeye dahil edin.
RAG içinde embedding nerede kullanılır?
RAG akışında vektör araması, cevap için ilgili kaynakları getirebilen yöntemlerden biridir. Modelin cevabı oluşturması sonraki adımdır. Kaynağın bulunması ile doğru cevabın yazılması iki ayrı başarı ölçütüdür. RAG rehberimiz bu aşamaları örnek bir ürün kataloğuyla anlatıyor.[4]
Aynı bilgi tabanında arama testi ve cevap testi için ayrı kayıt tutun. İlkinde beklenen bölümün bulunup bulunmadığını ölçün. İkincisinde ürün, koşul ve uyarının doğru aktarıldığını inceleyin. Sorunun hangi aşamada başladığını gördüğünüzde model veya veri değişikliği daha anlamlı hale gelir.
Örneğin doğru belge sürekli ikinci sırada geliyor fakat model birinci sonucu esas alıyor. Bu durumda yeniden sıralama, belge filtreleme veya modele verilen bağlam biçimini inceleyin. Bu üç değişikliği aynı anda yapmak yerine her denemenin etkisini ayrı kaydedin.
Küçük Türkçe arama denemesi hazırlayın
On kurgusal soru seçin. Üçü tam ürün kodu, üçü doğal dille ifade edilen soru, ikisi yazım hatalı terim ve ikisi belgede karşılığı olmayan ihtiyaç içersin. Her soru için beklenen kaynak veya “kaynak yok” sonucunu önce yazın.
Bir arama yönteminde doğru bölüm on sorudan yedisinde ilk üçe girdi, diğerinde sekizinde girdi diyelim. Bu sayı tek başına yeterli karar verdirmez. Hangi sorunun düzeldiğini ve hangi önemli sorunun bozulduğunu inceleyin. Özellikle modelin eski ürün bilgisini daha yukarı taşıdığı bir değişiklik, toplam puan artsa bile sizin için kabul edilemeyebilir.
Sorgu sonuçlarını belge adı, bölüm, sıra ve sürüm bilgisiyle kaydedin. Belge güncellemelerinden sonra aynı testleri çalıştırın. Böylece model, indeks veya kaynak değiştiğinde hangi sonucun neye bağlı olarak değiştiğini anlayabilirsiniz.
Model değiştirirken indeksi nasıl yenilemeli?
Yeni embedding modeline geçmeden önce eski indeksin ayarlarını kaydedin. Model adı ve boyut yanında, belgelerin hangi metin sürümünden üretildiğini de belirtin. Aynı model adıyla farklı parça düzeni kullanılmışsa sonuçlar değişebilir. Denemeyi tekrarlamak için bu iki bilgiyi birlikte saklayın.
Yeni temsilleri ayrı bir deneme kümesinde oluşturun. Aynı belge ve sorgu grubuyla önce eski, sonra yeni yöntemi çalıştırın. Eski ve yeni vektörleri tek arama sonucunda karıştırmak yerine her kümenin kendi uyumlu modelini kullanın. Böylece yakınlık sıralaması karşılaştırılabilir bir deneyden gelir.
Örneğin yeni model Türkçe eş anlamlıları daha iyi yakalıyor ama A-12 ve A-21 gibi benzer kodları karıştırıyor olabilir. Bu durumda “yeni model daha iyi” demek yerine doğal dilde arama ile tam kod eşleşmesini ayrı raporlayın. Tam kodu filtre olarak tutup açıklamayı vektör aramasıyla bulmak ayrı bir deneme olabilir.
Belge metnindeki bir değişiklik de aynı dikkatle ele alınmalıdır. Bir bakım paragrafı güncellendiğinde eski vektör yeni metni temsil etmez. Hangi parçaların yeniden işleneceğini ve eski kayıtların ne zaman aramadan çıkacağını belirleyin. Kaynak linkinin yeni belgeye gitmesi, arama vektörünün de yenilendiğini tek başına göstermez.
Geçişten sonra örnek sorguları canlı kullanım düzenine benzer filtrelerle tekrarlayın. İlk sonuç doğru belge mi, kayıtlı bölüm hâlâ açılıyor mu ve eski sürüm kullanıcılara gösteriliyor mu? Başarısız bir geçişi incelemek için önceki indeks ayarını ve karşılaştırma sonuçlarını kaydedin. Küçük bir arşivde bile bu kayıt, daha sonra neden farklı sonuç alındığını anlamayı kolaylaştırır.
Sık sorulan sorular
Embedding bir model eğitimi midir?
Bir embedding modeliyle belge temsili üretmek, belgeyi sohbet modelinin ağırlıklarına öğretmekten farklıdır. Arama için temsiller oluşturulur ve ilgili metin daha sonra modele bağlam olarak verilebilir.[1][4]
Yüksek benzerlik puanı güvenilir bilgi demek mi?
Puan kullanılan ölçüye göre yakınlığı gösterir. Bilginin güncelliği ve doğruluğu için belgeyi ayrıca inceleyin. Tarih, ürün ve yetki koşullarını puanın yerine kullanmayın.[1][3]
Vektör araması için ayrı veritabanı zorunlu mu?
Küçük denemeler doğrudan vektör karşılaştırmasıyla yapılabilir. Büyük koleksiyonlarda saklama, filtreleme ve arama ihtiyaçlarına göre ayrı altyapı veya mevcut veritabanı uzantısı değerlendirilebilir.[1][3]
Kaynaklar
- Sentence Transformers, Semantic Search. Bilginin alındığı tarih: 6 Kasım 2026.
- Reimers ve Gurevych, Sentence-BERT. Bilginin alındığı tarih: 6 Kasım 2026.
- pgvector, Vector similarity search for Postgres. Bilginin alındığı tarih: 6 Kasım 2026.
- Anthropic, Contextual Retrieval. Bilginin alındığı tarih: 6 Kasım 2026.