RAG, yapay zekânın yanıt vermeden önce bir bilgi kaynağında arama yapması ve bulduğu içeriği yanıta dayanak olarak kullanmasıdır. İngilizce adı Retrieval-Augmented Generation. Örneğin bir destek botu, ürünün kullanım kılavuzunda ilgili bölümü bulup o bölüme dayanarak yanıt verebilir.[1][2]
Bu rehber, RAG’ın nasıl çalıştığını kurgusal bir ürün kataloğuyla açıklıyor. Aynı örnek üzerinden belge hazırlamayı, arama sonucunu kontrol etmeyi ve modelin cevabını değerlendirmeyi göreceksiniz.
RAG hangi problemi çözer?
Bir dil modeli, şirketinizin son yayımladığı bakım kılavuzunu veya geçen hafta değişen ürün listesini eğitiminden biliyor olmayabilir. RAG ile uygulama, seçtiğiniz kaynaklardan soru anında bilgi getirir. Model, gelen parçaları kullanıcı sorusuyla birlikte değerlendirir.[1][2]
Diyelim ki kullanıcı “A-12 cihazı suyla yıkanır mı?” diye sordu. Sistem arşivden A-12 bakım bölümünü bulur. Bu bölüm kuru bez öneriyorsa yanıtın dayanağı o metindir. İlgili belge bulunamadığında sistemin açıklama istemesi veya bilginin bulunmadığını söylemesi gerekir. Böyle bir davranışı ürününüz için açıkça tasarlayıp sınayın.
Bir bilgi tabanına belge eklemek, dil modelinin ağırlıklarını yeniden eğitmekten farklıdır. Arama aşaması harici kaynağı kullanır. Bu yüzden belge sürümü değiştiğinde, yeni metnin aramaya doğru biçimde girdiğini kontrol etmek önemlidir. Modelin nasıl yanıt ürettiğini anlamak için LLM rehberimize bakabilirsiniz.[1][2]
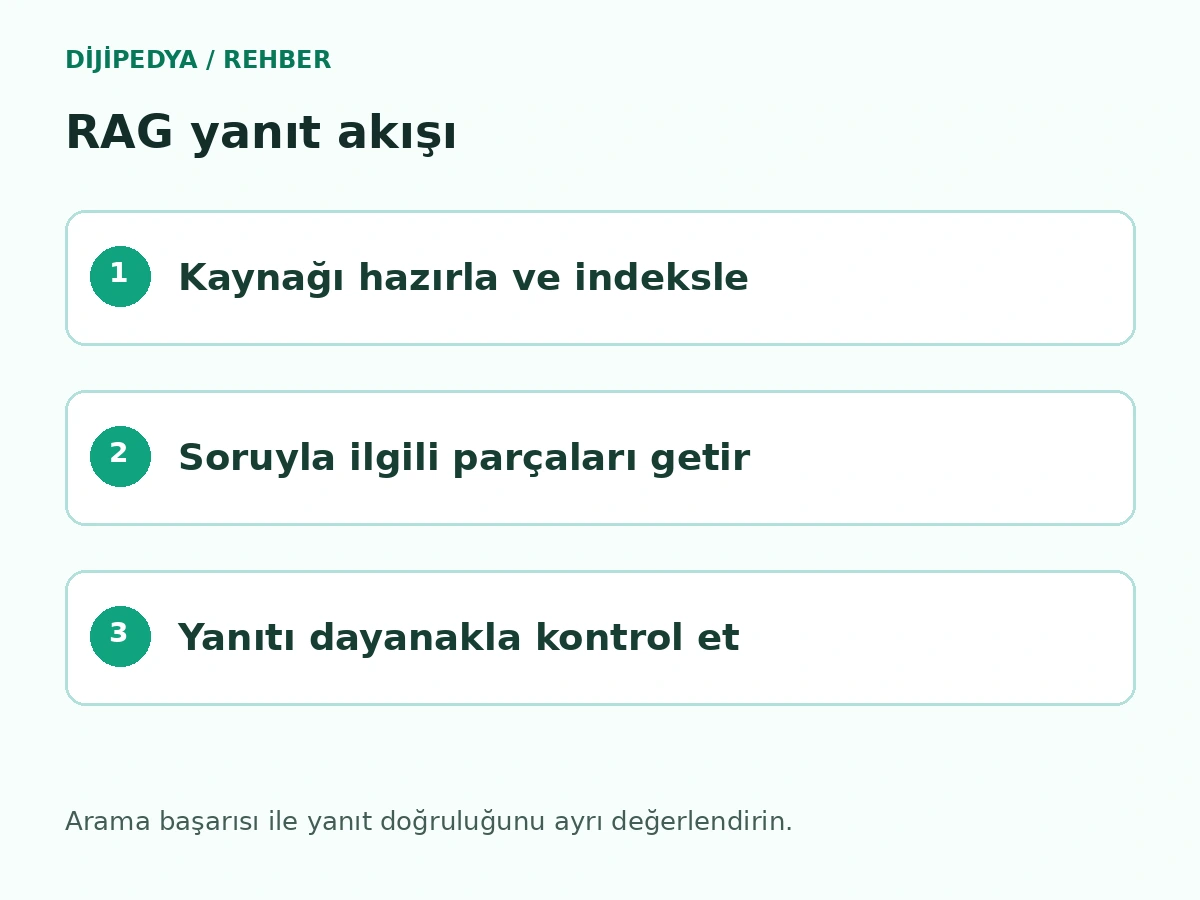
Belgeden yanıta hangi adımlar izlenir?
İlk aşama kaynak hazırlığıdır. Uygulama PDF, metin veya başka desteklenen dosyalardan içerik çıkarır. Uzun belgeleri parçalara bölebilir. Arama için gerekli temsil ve kayıtlar hazırlanır. Parçaların hangi dosyadan geldiğini belirten ad, sürüm ve bölüm gibi alanlar sonradan denetim yapmayı kolaylaştırır.[2][3]
İkinci aşamada kullanıcının sorusu aranır. Bir sistem benzer anlama sahip parçaları vektör aramasıyla, tam terimleri kelime aramasıyla veya iki yöntemi birleştirerek bulabilir. Bazı akışlar ilk sonuçları ikinci bir modelle yeniden sıralar. Seçim, veri türüne ve aradığınız bilginin biçimine göre değişir.[2][3]
Son aşamada seçilen içerik dil modeline bağlam olarak verilir. Model, bu parçaları kullanarak bir yanıt yazar. Kaynak gösterimi eklenmişse, kullanıcının dayanak metni açıp kontrol edebilmesi gerekir. Alıntı veya bağlantı görünmesi tek başına cevabın o kaynak tarafından desteklendiğini göstermez.[2][3]
| Aşama | Kontrol sorusu |
|---|---|
| Metin çıkarma | Belgedeki gerekli bilgi metne geçti mi? |
| Parçalama | Ürün adı, kural ve istisna birlikte okunabiliyor mu? |
| Arama | Doğru ve güncel bölüm ilk sonuçlara giriyor mu? |
| Yanıt | Cevap, getirilen metnin söylediğini koruyor mu? |
| Kaynak | Kullanıcı dayanağı açıp inceleyebiliyor mu? |
Küçük bir bilgi tabanı hazırlayın
İlk denemede bütün arşivi eklemek yerine üç kısa belge seçin. Birinci dosya A-12 bakım kılavuzu, ikinci dosya B-30 bakım kılavuzu, üçüncü dosya ise destek kanalları olsun. Gerçek müşteri veya ödeme bilgisi kullanmadan, soru ile kaynak arasındaki ilişkiyi inceleyebilirsiniz.
Örnek A-12 dosyasında şu bilgiler yer alabilir: ürün kodu A-12, bakım başlığı, kuru bezle temizlik, suya daldırmama uyarısı ve 5 Kasım 2026 sürüm tarihi. B-30 dosyasında farklı bir bakım kuralı yazın. Böylece sistemin ürünleri birbirine karıştırıp karıştırmadığını ölçebilirsiniz.
Taranmış PDF kullanıyorsanız ilk kontrol metnin çıkarılıp çıkarılmadığıdır. Bir belgede cümle görünüyor ama arama için hazırlanan metinde yoksa, model o cümleyi kaynaktan alamaz. OCR rehberindeki arama ve kopyalama kontrolleri bu aşamada işe yarar.
Parçalar doğru bağlamı koruyor mu?
Bir bakım maddesi tek başına “ılık su kullanın” diyebilir. Hangi parçanın temizleneceği başlıkta, “gövdeyi suya sokmayın” uyarısı bir sonraki paragrafta kalabilir. Arama yalnızca ilk cümleyi bulursa model eksik bilgiyle cevap verir. Önizlemede parçaları gerçek soru ve beklenen yanıtla birlikte okuyun.[2][3]
Her belgeye aynı parçalama ayarını uygulamak zorunda değilsiniz. Sık sorulan sorular dosyasında soru ve cevabı birlikte tutmak, uzun kılavuzda bölüm başlığını ilgili metinle taşımak daha anlamlı olabilir. Satırları koparan bir tablo veya tekrar eden sayfa başlığı için önce metin çıkarma düzenini inceleyin.
Bağlam penceresi de seçim üzerinde etkilidir. Getirilen metin, sohbet geçmişi ve talimatlar modelin girdisine eklenebilir. Çok sayıda parça eklemek modelin daha fazla metin görmesini sağlar, ancak ilgili kısmın kolayca kullanılacağına dair güvence vermez. Bağlam penceresi yazımız bu kapasiteyi ve belgeyi bölme seçeneklerini açıklıyor.[2]
Vektör araması ve anahtar kelimeyi birlikte düşünün
Kullanıcı “ıslatabilir miyim?” diye sorabilir. Belgede “suya daldırmayın” yazıyorsa anlam benzerliği üzerinden arama bu ilişkiyi bulmaya yardımcı olabilir. Buna karşılık A-12 gibi kesin bir kodun doğru eşleşmesi gereken durumda tam terim araması önem kazanır.[2][3]
Örneğin ilk arama sonucu benzer bakım talimatı içeren B-30 belgesini getirdi. İkinci sırada doğru A-12 kılavuzu var. Bu durumda ürün kodu filtresi, anahtar kelime eşleşmesi veya sonuçları yeniden sıralama yöntemini denemek için belirgin bir gerekçeniz olur. Sadece cevap metnini düzeltmek, yanlış belgenin gelmesi sorununu çözmez.
Ayar değiştirdiğinizde aynı soru grubuyla tekrar ölçün. Tek bir başarılı örnek yerine farklı ürün kodları, doğal ifadeler ve eksik bilgi içeren sorular kullanın. Bir yöntem tam kodlarda iyileşirken, günlük dille yazılan sorularda gerileyebilir.
Arama ve yanıtı ayrı değerlendirin
İlk denemede on soru hazırladığınızı düşünün. Sekiz soruda beklenen kaynak ilk üç parça arasında bulunuyor. Bu örnekte ilk üçte doğru kaynak bulma oranı yüzde 80’dir. Ardından cevabın doğru olup olmadığını ayrı kaydedin. Doğru kaynak bulunan sekiz sorudan yalnızca altısı doğru yanıtlanmışsa arama ve yazım aşamalarını ayrı incelemeniz gerekir. Bu sayılar açıklama amacıyla seçilmiştir.
Kaynak kontrolü için her soruya önceden bir beklenen belge ve bölüm yazın. Cevap kontrolünde ürün adı, uyarı ve tarih gibi kritik bilgileri işaretleyin. Bir belgeye link verilmiş olsa bile linkin cevabı gerçekten desteklediğini kontrol edin.
| Sonuç | Önce bakılacak yer |
|---|---|
| Doğru metin hiçbir arama sonucunda yok | Belge içeriği, indeks ve arama |
| Doğru kaynak var, yanlış ürün kullanılmış | Filtre, bağlam seçimi ve yanıt |
| Kaynakta olmayan bilgi eklenmiş | Yanıt talimatı ve değerlendirme |
| Eski sürümden cevap verilmiş | Geçerli sürüm ve arşiv düzeni |
| Hiç bilgi yokken cevap verilmiş | Sonuç bulunamadığında izlenen yol |
Bilgi yoksa sistem ne söylemeli?
Ürün belgelerinizde teslim süresi bulunmayabilir. Buna rağmen kullanıcı süre sorabilir. Bu senaryoyu ilk test grubuna ekleyin. Yanıtın “Bu kaynaklarda teslim süresi belirtilmiyor” gibi açık bir ifadeyle durması, kurgusal örneğimizde başarılı davranıştır.
Soru birden fazla ürünü kapsıyorsa ilk adım ürün kodunu istemek olabilir. İki güncel belge çelişiyorsa asistan, belgelerin ikisini ve tarihlerini gösterip doğrulama için yönlendirebilir. Hangi davranışın uygun olduğunu ekibinizin gerçek destek akışına göre belirleyin.
Örnek bir yanıt talimatı şöyle kurulabilir:
Yanıtını getirilen ürün belgeleriyle destekle.
Ürün kodunu kontrol et ve kaynak bölümünü belirt.
Belgede olmayan tarih, fiyat veya koşulu ekleme.
Belgeler çelişiyorsa çelişkiyi göster.
Bilgi bulunamıyorsa bunu açıkça söyle.
Talimatı doğrulama mekanizmasıyla birlikte kullanın. Uygulama kaynak bulamadığında bunu teknik olarak tespit edebiliyorsa, kullanıcıya gösterilen yönlendirmeyi ayrı bir kural olarak uygulamayı değerlendirin.
Belgeleri ve erişimi nasıl yönetmeli?
Bir kullanıcı yalnızca kendi çalışma alanındaki belgeleri görmeli ise bu sınırı belge aramasında uygulayın. “Gizli belgeleri gösterme” yazmak tek başına yetki denetimi değildir. Bilgi tabanına yükleme, kaynakları erişime açma ve cevapta gösterme adımlarını ayrı düşünün.
Belge değiştiğinde eski ve yeni sürümlerin birlikte aranıp aranmayacağına karar verin. Eski bir politika arşivde tutulacaksa, sorgu sonucunda geçerli belgeyle karışmaması için uygun sürüm bilgisini ekleyin. Pilot sorularınızı yeni sürümle tekrar çalıştırın.
Kullanıcının sorusu anlık stok veya sipariş durumuysa, düzenli aralıklarla güncellenen belge arşivi yeterli olmayabilir. Bu durumda yetkili canlı veri kaynağından alınan bilginin zamanı ve erişim koşulları ayrı tasarlanır. Belge araması ile gerçek zamanlı veri erişiminin sınırını kullanıcıya açık biçimde gösterin.
Kodsuz denemeye nereden başlamalı?
Kişisel belge çalışması için AnythingLLM rehberi yerel ve bulut bileşenlerini seçme adımlarını gösteriyor. Bir bilgi tabanını chatbot akışına bağlamak için Dify rehberindeki örnek kullanılabilir.[3][4]
İki durumda da önce tek belge ve birkaç soruyla ilerleyin. Arama sonucunun hangi bölümden geldiğini, cevapta hangi bilginin kullanıldığını ve belirsiz sorulara nasıl davranıldığını kaydedin. Hedef, ilk aşamada çok belge yüklemekten önce güvenilir bir kontrol yolu kurmaktır.
Bir arama hatasını adım adım inceleyin
Kurgusal pilotta kullanıcı “A-12 kapağı yıkanabilir mi?” diye soruyor. İlk sonuç gövde temizliği, ikinci sonuç B-30 kapak temizliği, üçüncü sonuç ise A-12 için teknik özellikler. Model bu üç parçadan birine dayanarak kesin cevap verirse sorun, doğru kaynağın seçilen sonuçlar arasında olmamasıyla başlar.
Önce A-12 belgesinde kapak temizliği bilgisinin bulunup bulunmadığını kontrol edin. Bilgi gerçekten yoksa eksik kaynak olarak işaretleyin. Bilgi varsa çıkarılan metni açın. PDF’de “Kapak” başlığı ayrı bir sütunda kaldığı için paragrafla birleşmediyse önce belgeyi yeniden işleyin. Parça düzgünse arama sorgusunu ve ürün kodu eşleşmesini inceleyin.
Beklenen paragrafı elle modele vererek ikinci bir deneme yapın. Bu deney, arama aşamasını geçici olarak devreden çıkarır. Model doğru paragrafla da yanlış yanıt veriyorsa yorumlama sorunu kalmıştır. Doğru yanıt veriyorsa belge aramasının getirdiği içeriğe odaklanın. Her iki durumda aynı soruyu ve aynı model ayarını kullanın.
Sürüm kontrolü için bir test daha ekleyin. Örneğin eski belge kapağın suyla temizlendiğini, güncel belge ise kuru bez kullanıldığını söylüyor. Önce hangi belgenin geçerli olduğunu kesinleştirin. Ardından aramanın eski belgeyi ilk sıraya getirip getirmediğine bakın. Kaynağı değiştirince eski cevabın dönmesi, indeksin veya yayımlanan veri kümesinin yeniden kontrol edilmesini gerektirir.
Her denemenin kaydında dört bilgi tutun. Soru, beklenen kaynak, getirilen kaynak ve gerçek yanıt. Bu dörtlü, hatanın ilk görüldüğü aşamayı belirlemenize yardımcı olur. Sonraki sürümde bütün soruları yeniden çalıştırarak bir düzeltmenin diğer cevapları nasıl etkilediğini görün.
Sık sorulan sorular
RAG internet araması mı?
İnternet araması bir kaynak olabilir. RAG, şirket içi belgeler veya başka seçilmiş kaynaklardan bilgi getiren uygulamalarda da kullanılabilir. Belirleyici olan yanıt öncesi ilgili bilginin bulunup modele bağlam olarak verilmesidir.[1][2]
RAG yanlış cevapları önler mi?
Kaynakla çalışmayı mümkün kılar. Arama yanlış sonuç verebilir, belge güncel olmayabilir veya model metni hatalı yorumlayabilir. Bu nedenle arama ve yanıtı ayrı test edin.[2][3]
Her kısa belgeye RAG gerekir mi?
Küçük ve ilgili bir metni doğrudan bağlama eklemek bazı işlerde daha basit olabilir. Çok sayıda belge içinde seçici arama gerektiğinde RAG yaklaşımı değerlendirilebilir. Önce elinizdeki belgelerle ölçüm yapın.[2][4]
Kaynaklar
- Lewis ve arkadaşları, Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks. Bilginin alındığı tarih: 6 Kasım 2026.
- Anthropic, Contextual Retrieval. Bilginin alındığı tarih: 6 Kasım 2026.
- Dify, Knowledge Pipeline. Bilginin alındığı tarih: 6 Kasım 2026.
- AnythingLLM, Using documents in chat. Bilginin alındığı tarih: 6 Kasım 2026.