NVIDIA, 28 Ekim 2026’da konuşmayı yazıya döken açık ağırlıklı yeni modeli Nemotron 3.5 Transcribe‘ı yayımladı. Model ücretsiz indirilebiliyor, Türkçe dahil 40 dilde ses kayıtlarını yazıya çeviriyor, 8 konuşmacıya kadar kimin ne söylediğini ayırıyor ve 31 dilde İngilizceye ya da İngilizceden çeviri yapıyor. Lisansı ticari kullanıma da izin veriyor.
İçindekiler
Nemotron 3.5 Transcribe Nedir?
Nemotron 3.5 Transcribe, ses kayıtlarını metne dönüştürmek için geliştirilmiş bir model. Yazıya dökme, konuşmacı ayırma, çeviri ve ses üzerine soru cevaplamayı tek bir modelde topluyor. Yani bir toplantı kaydını verip hem dökümünü hem de “Ayşe bütçe hakkında ne dedi?” gibi bir sorunun cevabını alabiliyorsun.
Teknik tarafta bir konuşma kodlayıcısı ile hibrit Mamba ve Transformer mimarili bir uzmanlar karışımı (MoE) dil modeli birleştiriliyor. Toplam yaklaşık 30 milyar parametresi var ama her token için bunların yalnızca 4 milyarı çalışıyor. Bu da modeli boyutuna göre hızlı yapıyor (Hugging Face).
Türkçe Destekliyor mu?
Evet, ama bir farkla. Model kartındaki dil tablosunda Türkçe, konuşmayı yazıya dökme için “üretime hazır” kalitede ve kod değiştirme (konuşma sırasında dil karıştırma) desteğiyle listeleniyor. Ancak çeviri desteği olan 31 dil arasında Türkçe yok. Yani Türkçe bir kaydı Türkçe metne çevirebiliyorsun, ama model Türkçeyi doğrudan İngilizceye çevirmiyor.
Türkçe kayıtlar için şu iş akışı mantıklı: önce Nemotron ile Türkçe dökümü al, çeviri gerekiyorsa metni ayrı bir çeviri aracına ya da sohbet botuna ver. Seçenekler için çeviri yapan yapay zeka araçları listemize bakabilirsin.
Öne Çıkan Özellikler
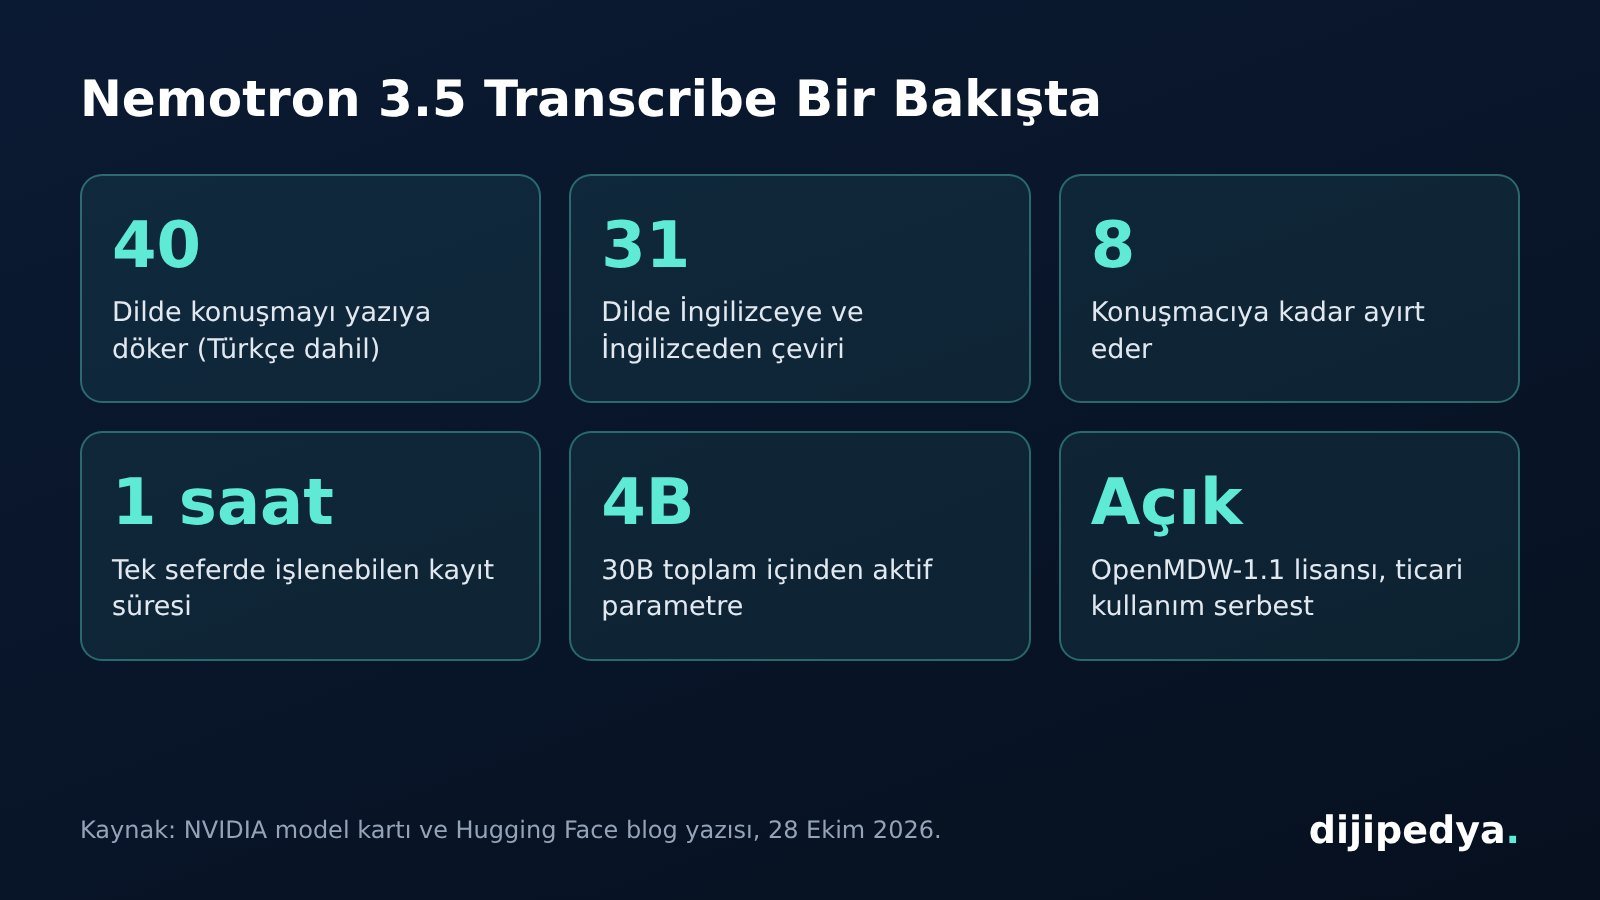
- 40 dilde yazıya dökme, 31 dilde İngilizceyle çift yönlü çeviri.
- Konuşmacı ayırma: 8 konuşmacıya kadar etiketleme; bu özellik 13 dilde çalışıyor.
- Uzun kayıtlar: Tek seferde 1 saate kadar ses.
- Kelime düzeyinde zaman damgası: Altyazı ve video düzenleme için işe yarıyor.
- Doğal dille komut: “Sadece ikinci konuşmacıyı yaz” gibi istekler verilebiliyor.
- Lisans: OpenMDW-1.1. Model kartına göre ticari ve ticari olmayan kullanıma uygun.
Test Sonuçları
Aşağıdaki sonuçlar NVIDIA’nın kendi paylaştığı tablolardan. Hata oranlarında (WER) düşük değer daha iyi demek.
| Test | Sonuç | Not |
|---|---|---|
| Hugging Face Open ASR, İngilizce | Yüzde 5,33 ortalama WER | Açık modeller arasında birinci |
| Open ASR, çok dilli (7 dil) | Yüzde 4,62 ortalama WER | Karşılaştırmadaki en düşük |
| Open ASR, uzun kayıt | Yüzde 10,98 ortalama WER | Karşılaştırmadaki en düşük |
| Artificial Analysis AA-WER | Yüzde 2,8 | Açık modeller arasında ilk sırayı paylaşıyor |
| David AI konuşmacı ayırma (21 dil) | Yüzde 18,26 hata | Açık modellerde birinci |
TechCrunch da modelin Hugging Face Open ASR sıralamasında açık ağırlıklı modeller arasında ilk sıraya yerleştiğini doğruluyor. Türkçe için ayrı bir hata oranı yayımlanmadı.
Nasıl Denenir ve Kullanılır?
- Tarayıcıdan dene: Hugging Face’teki demo sayfası ya da ModelScope Studios.
- Kendi sunucunda çalıştır: Model Hugging Face ve ModelScope’tan indirilebiliyor, vLLM veya SGLang-Omni ile sunulabiliyor.
- Hazır API: Baseten, DeepInfra ve Simplismart üzerinden barındırılan sürüm var.
- Yakında: Kişisel bilgisayarda çalıştırmak için NeMo-Speech.cpp desteği ve NVFP4 gibi sıkıştırılmış sürümler.
Modelin tam sürümü için ciddi bir GPU gerekiyor; sıradan bir dizüstü bilgisayarda çalıştırmak şimdilik pratik değil. NVIDIA, gelecek NVFP4 sürümüyle tek bir RTX PRO 6000 Blackwell ekran kartında 100 saatlik sesin 3 dakikadan kısa sürede işlendiğini söylüyor. Kurulum istemeyen biri için sesi yazıya çeviren yapay zeka araçları listemizdeki hazır servisler daha kolay.
Granary v2 Veri Seti
NVIDIA modelle birlikte Granary v2 veri setini de yayımladı. Veri seti 48 dilde ve 16 kaynaktan toplam 463.062 saatlik konuşma içeriyor; ilk sürümde 25 dil vardı. Her kayıt için ham ve temizlenmiş döküm, altyazı, soru cevap çiftleri ve kalite puanlı çeviriler bulunuyor (Hugging Face). Kendi ses modelini eğitmek isteyen geliştiriciler için önemli bir kaynak.
Sınırlar ve Dikkat Edilecekler
- Model canlı ses için değil, kaydedilmiş dosyalar için tasarlandı. Anlık toplantı altyazısı için uygun değil.
- Türkçeden İngilizceye doğrudan çeviri yok.
- Konuşmacı ayırma 13 dilde destekleniyor; NVIDIA bu dillerin Türkçeyi kapsayıp kapsamadığını blog yazısında ayrıca belirtmiyor.
- Test sonuçları şirketin kendi ölçümü; Türkçeye özel bağımsız test henüz yok.
Sıkça Sorulan Sorular
Nemotron 3.5 Transcribe ücretsiz mi?
Evet. Model açık ağırlıklı olarak Hugging Face ve ModelScope’tan ücretsiz indirilebiliyor. OpenMDW-1.1 lisansı ticari kullanıma da izin veriyor.
Nemotron 3.5 Transcribe Türkçe biliyor mu?
Türkçe konuşmayı yazıya dökebiliyor ve model kartında bu özellik üretime hazır olarak işaretli. Ancak Türkçe ile İngilizce arasında çeviri desteği yok.
Kaç konuşmacıyı ayırt edebiliyor?
Bir kayıtta 8 konuşmacıya kadar kimin konuştuğunu etiketleyebiliyor. Bu özellik 13 dilde çalışıyor.
Canlı toplantıda kullanılabilir mi?
Hayır. Model kaydedilmiş ses dosyaları için tasarlandı, canlı akış desteği yok. Tek seferde 1 saate kadar kayıt işleyebiliyor.
Nemotron 3.5 Transcribe nasıl denenir?
Hugging Face demo sayfasından tarayıcıda deneyebilir, Baseten veya DeepInfra gibi servislerden API ile kullanabilir ya da vLLM ile kendi sunucunda çalıştırabilirsin.
Kaynaklar
- Nemotron 3.5 Transcribe and Granary v2 (NVIDIA / Hugging Face, 28 Ekim 2026)
- NVIDIA-Nemotron-3.5-Transcribe-30B-A4B model kartı (NVIDIA / Hugging Face)
- Voice AI in vogue: NVIDIA releases new open transcription model (TechCrunch, 28 Ekim 2026)
Daha fazla güncel gelişme için Yapay Zeka Haberleri sayfamıza göz at.
Güncel yapay zeka haberlerini, yeni araçları ve pratik ipuçlarını kaçırma. Haber bültenimize ücretsiz abone ol, doğrudan mailine gelsin!
Dijipedya’da İlgili İçerikler
- Sesi Yazıya Çeviren En İyi Yapay Zeka Araçları
- Çeviri Yapan En İyi Yapay Zeka Araçları
- Otter ve Fireflies Nedir? Toplantı Notu Alma
- İnternetsiz Çalışan Ücretsiz Yapay Zekâ Araçları
- TurboScribe ile Ses ve Videoyu Yazıya Çevirme
- NVIDIA RTX Spark Nedir?
- ComfyUI Nedir, Nasıl Kurulur?
- NotebookLM ile Ders Çalışma ve Not Düzenleme